
Tabla de Contenidos
Hister
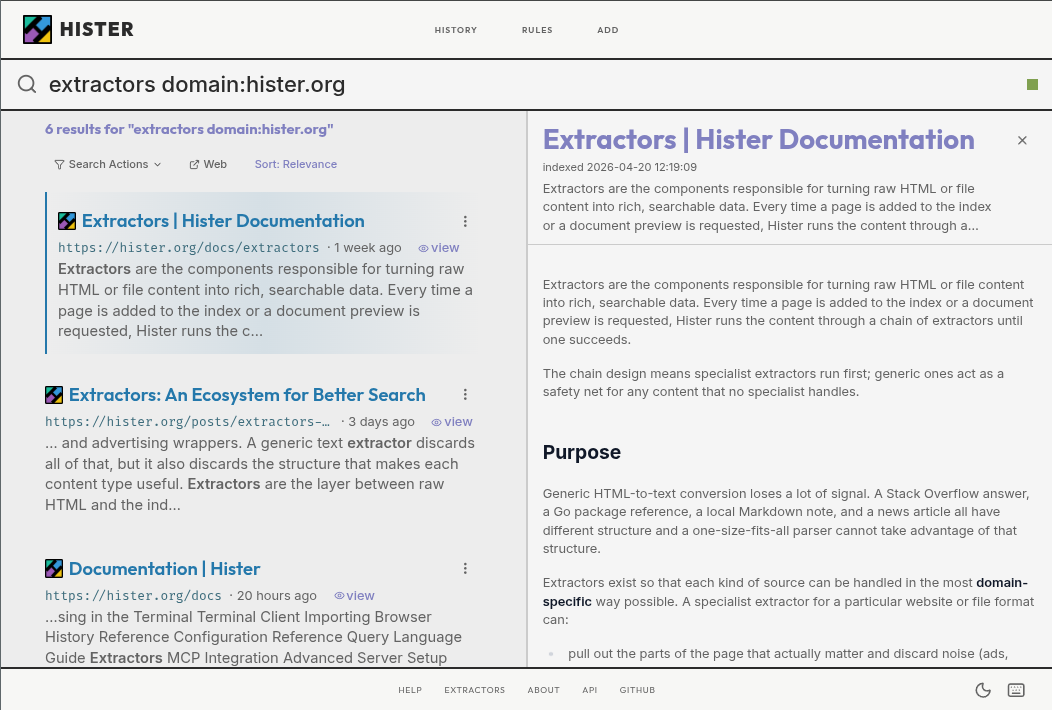
Buscador autoalojado para páginas web y archivos. Básicamente es un buscador mejorado del historial de navegación, indexa las páginas que visitas para poder buscar por su contenido.
Casos de uso
Recuperar algo que viste en Internet
En vez de recordar la URL o el título, puedes buscar una frase o concepto que recuerdes del contenido de la página. La extensión del navegador va indexando automáticamente las páginas que visitas.
Crear tu propio buscador personal de documentación
Puedes indexar documentación, manuales, wikis o sitios completos y consultarlos después mediante búsqueda de texto completo. También dispone de crawler para indexar sitios recursivamente.
Buscar en tus archivos locales
Hister puede indexar directorios y archivos locales, permitiendo buscar conjuntamente información que tienes en tu ordenador y contenido web.
Búsqueda semántica
Además de buscar palabras exactas, puedes habilitar embeddings para encontrar documentos por significado. Por ejemplo, buscar algo relacionado con “autenticación de usuarios” aunque el documento hable de “OAuth/OIDC”.
Darle memoria documental a un agente de IA
Mediante MCP, un asistente compatible puede consultar directamente el índice de Hister. Esto permite plantear preguntas a un LLM sobre las páginas y documentos que has recopilado.
Buscar desde terminal
No estás limitado a la interfaz web: Hister ofrece acceso desde CLI/TUI, lo que encaja bien con workflows de desarrollo o administración.
Construir un buscador interno para un corpus concreto
Puedes desplegarlo sobre infraestructura propia y utilizarlo como buscador de una colección de documentación o contenidos, en lugar de depender de un buscador externo. También soporta múltiples usuarios con índices separados.
Recuperar tu historial de navegación existente
No tienes que empezar desde cero: puede importar el historial del navegador y convertirlo en un índice consultable.
Mantener el índice bajo tu control
Por defecto no necesita telemetría ni un servicio cloud obligatorio; puedes ejecutarlo localmente o en infraestructura que controles. Esto resulta especialmente interesante para documentación privada o información sensible.
Almacenamiento
Según el desarrollador, de media, 1000 sitos web requieren sobre 100 MB de almacenamiento. Esto puede reducirse significativamente en un futuro porque ahora mismo se almacena todo el contenido HTML original y el texto extraído. Cuando no se almacene el HTML, la demanda de almacenamiento se reducirá en un 50-75%.
Indexación del contenido
Extensión para el navegador
Línea de comandos
El comando index usa la biblioteca HTTP estándar o un navegador (sin interfaz gráfica) para obtener automáticamente cualquier sitio web.